In-Sample y Out-of-Sample: cuál es la diferencia
Si ya tienes claro qué es el backtesting, piensa en tu histórico como información que cumple dos trabajos distintos.
| In-Sample (IS) | Out-of-Sample (OOS) | |
|---|---|---|
| Función | Desarrollar y ajustar el sistema | Evaluar el sistema terminado |
| Puedes cambiar parámetros | Sí | No, si quieres mantener una prueba limpia |
| Puedes añadir filtros | Sí | No después de conocer el resultado |
| Los datos influyen en el diseño | Sí | No deberían |
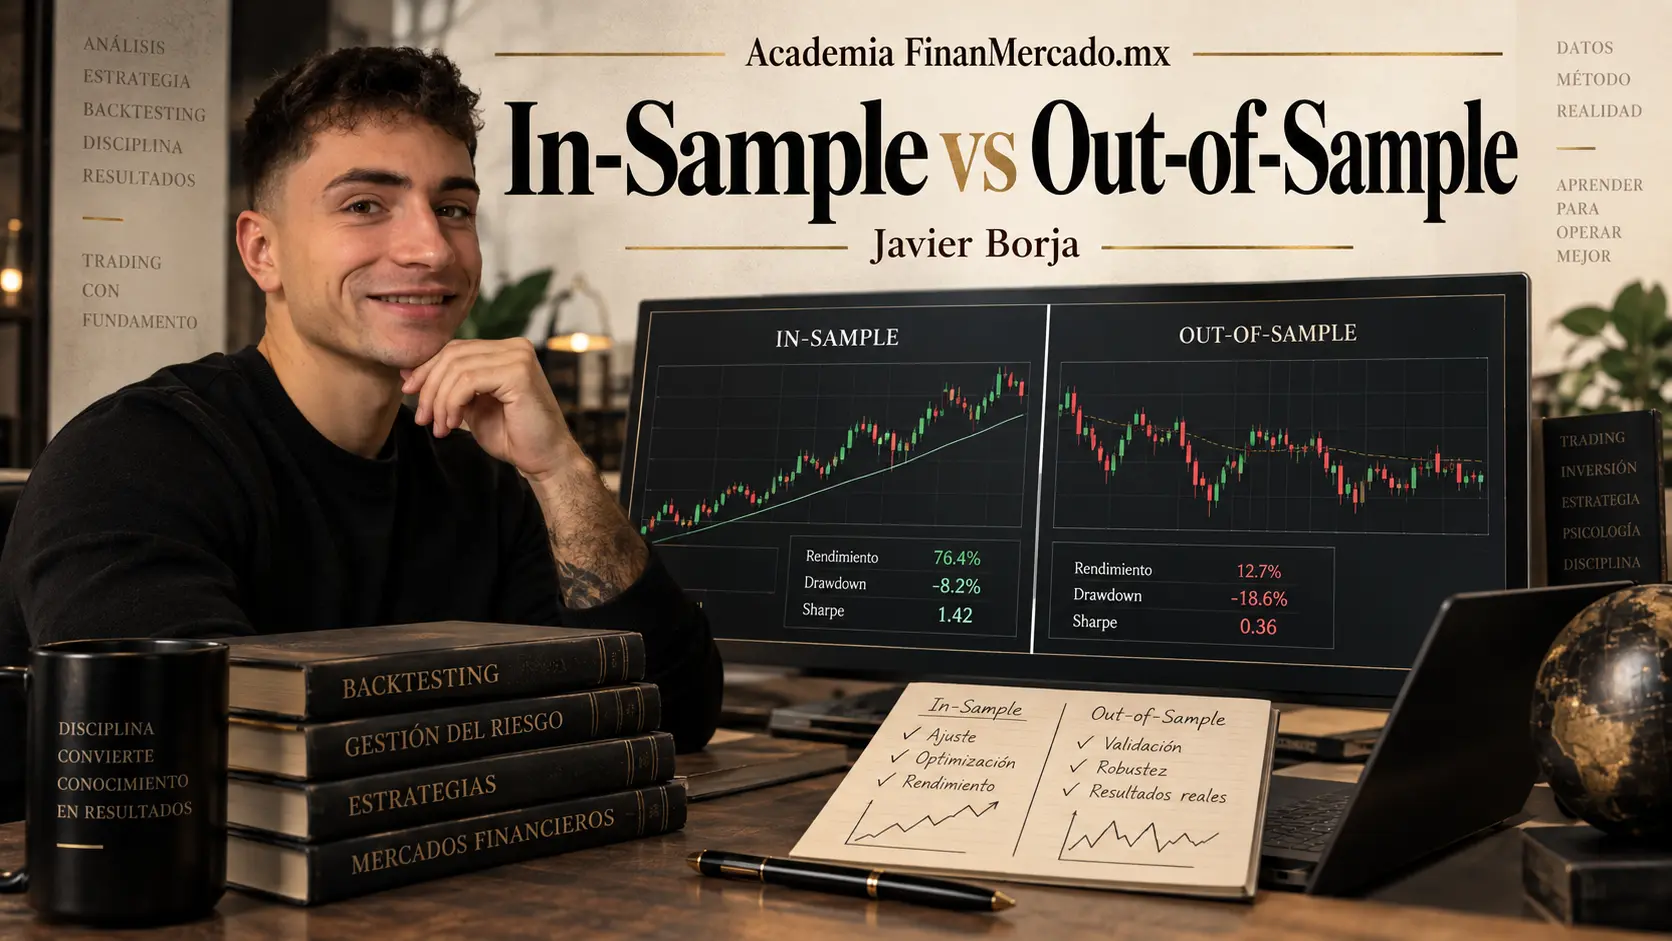
| Qué estás comprobando | Si puedes construir una hipótesis razonable | Si esa hipótesis conserva comportamiento fuera de la muestra de desarrollo |
Una analogía ayuda mucho.
Imagina que estás estudiando para un examen.
El In-Sample es tu material de práctica. Puedes resolver ejercicios, equivocarte, cambiar tu método y volver a intentarlo.
El Out-of-Sample es un examen que dejaste cerrado mientras estudiabas.
Si abres ese examen, ves las preguntas que fallaste y después modificas tu preparación específicamente para responderlas, ese examen ya dejó de medir lo mismo.
Con un sistema de trading pasa exactamente ese problema.
Por qué necesitas datos que tu sistema no haya “visto”
Durante el desarrollo de una estrategia tomas decisiones constantemente.
Cambias una entrada. Pruebas otro stop. Añades un filtro. Eliminas un horario. Comparas parámetros. Descartas una condición que empeoraba los resultados.
Cada decisión utiliza información del pasado.
El peligro aparece cuando, después de suficientes ajustes, el sistema termina capturando no solo una posible ventaja, sino también particularidades accidentales de esa muestra.
Eso nos acerca al overfitting o sobreajuste en trading.
Imagina que dispones de diez años de datos y pruebas 300 variaciones de una estrategia. Es bastante probable que alguna resulte muy atractiva simplemente porque encajó especialmente bien con esos diez años.
No significa automáticamente que encontraste una ventaja.
Tal vez encontraste una combinación muy buena para explicar un pasado que ya conocías.
Por eso yo no veo el Out-of-Sample como una máquina que responde:
“Esta estrategia funciona.”
Lo veo de una forma bastante más útil:
el OOS comprueba si el comportamiento que encontraste es capaz de generalizar, al menos parcialmente, fuera de los datos que utilizaste para encontrarlo.
Es una diferencia pequeña en palabras y enorme en la forma de investigar sistemas.
Cómo separar In-Sample y Out-of-Sample correctamente
La mecánica es fácil.
Lo difícil es respetarla cuando los resultados no son los que esperabas.
1. Reserva el Out-of-Sample antes de desarrollar
Supongamos que tienes datos de 2016 a 2025.
Podrías decidir, por ejemplo:
- 2016-2022: In-Sample.
- 2023-2025: Out-of-Sample.
Es un ejemplo, no una regla universal de 70/30.
Lo importante es que reserves el segundo periodo antes de utilizarlo para tomar decisiones sobre la estrategia.
A partir de ese momento, tu desarrollo ocurre en 2016-2022.
Puedes trabajar ahí.
Puedes descubrir que una regla estaba mal planteada, cambiarla, probar otra hipótesis y analizar qué ocurre.
Pero 2023-2025 permanece apartado.
Si consultas continuamente ese periodo para decidir qué cambios hacer, su independencia se va perdiendo.
Antes de hacer cualquier separación, además, necesitas una base fiable. Por eso conviene dominar primero cómo preparar buenos datos históricos para backtesting.
Un split perfecto entre datos malos sigue produciendo un backtest malo.
2. Mantén el orden temporal
En trading, normalmente tiene sentido que el Out-of-Sample ocurra después del periodo In-Sample.
Por ejemplo:
IS → 2016-2022
OOS → 2023-2025
Eso reproduce mucho mejor la realidad del trader:
pasado conocido → desarrollo → datos posteriores.
Mezclar observaciones aleatoriamente entre ambos grupos puede ser problemático en series temporales porque el tiempo contiene información.
Una estrategia no debería beneficiarse indirectamente de información de 2025 para demostrar después que habría funcionado en 2021.
No significa que nunca exista una metodología estadística más sofisticada. Significa que, para entender correctamente el concepto IS/OOS, no debes tratar una serie temporal como una bolsa de observaciones independientes que puedes barajar sin pensar en el orden.
Qué haces dentro del In-Sample
El In-Sample es tu zona de desarrollo.
Aquí puedes investigar.
Supongamos que tu sistema tiene:
- una condición de tendencia;
- una entrada;
- un stop;
- un objetivo;
- un filtro horario;
- varios parámetros.
Puedes estudiar diferentes configuraciones dentro del IS.
Puedes descubrir que una regla es innecesaria. Puedes analizar si un parámetro tiene sentido. Puedes rechazar una idea que no muestra el comportamiento que esperabas.
Pero existe una trampa.
Desarrollar no significa buscar incansablemente el número que más dinero habría producido.
Por ejemplo, supongamos que pruebas una media móvil de:
20, 30, 40, 50, 60, 70, 80, 90 y 100 periodos.
La de 60 produce el mejor resultado.
Entonces pruebas:
55, 56, 57, 58, 59, 60, 61, 62, 63, 64 y 65.
Ahora 63 es todavía mejor.
Después pruebas 62.1, 62.2, 62.3…
Ya puedes ver hacia dónde va el problema.
No necesariamente estás entendiendo mejor el sistema. Puede que simplemente estés excavando cada vez más profundamente en las peculiaridades de la muestra.
Más adelante entraremos de lleno en la optimización de parámetros de una estrategia. Aquí basta con entender que la optimización pertenece a la fase de desarrollo, no a la evaluación OOS.
Si estás construyendo tus primeras pruebas y quieres revisar una plataforma con la que posteriormente practicar el proceso, puedes consultar Pepperstone y la promoción disponible mediante nuestro enlace. Antes de abrir una cuenta, revisa siempre las condiciones vigentes de la plataforma y del producto que quieras operar.
Congela las reglas antes de mirar el Out-of-Sample
Este es el punto crítico.
Antes de abrir el OOS deberías poder explicar exactamente qué vas a probar.
Según el sistema, eso puede incluir:
- mercado o universo;
- temporalidad;
- condiciones de entrada;
- condiciones de salida;
- stop;
- objetivo;
- filtros;
- horarios;
- parámetros;
- costes;
- reglas de gestión de la posición;
- condiciones en las que no operas.
Dicho de otra forma:
primero defines el examen; después lo corriges.
No al revés.
Supongamos que llegas al Out-of-Sample con estas reglas hipotéticas:
- entrada cuando se cumple A + B;
- stop a 1.5 ATR;
- salida mediante C;
- operaciones de 8:00 a 16:00;
- parámetro principal = 50.
Ejecutas el sistema.
Ahora ya puedes observar qué ocurrió.
Pero no deberías cambiar inmediatamente el parámetro de 50 a 63 porque descubriste que eso habría mejorado el OOS.
Tampoco eliminar los lunes porque las mayores pérdidas ocurrieron en lunes.
Ni añadir un filtro de volatilidad porque habría evitado tres operaciones malas.
Esas modificaciones pueden ser ideas perfectamente válidas para una nueva ronda de desarrollo.
Lo que ya no puedes hacer es fingir que el mismo OOS continúa siendo información nunca utilizada.
El error más importante: ajustar después de ver el OOS
Quiero detenerme aquí porque es probablemente la confusión más importante de toda esta lección.
Supongamos que construyes un sistema en In-Sample.
Tiene:
- media de 50;
- stop de 1.5 ATR;
- operaciones de lunes a viernes.
Lo pruebas en OOS.
Sale mal.
Analizas las operaciones y descubres que habría funcionado mucho mejor con:
- media de 63;
- stop de 1.8 ATR;
- sin operaciones los lunes.
Haces esos cambios.
Vuelves a probar sobre exactamente el mismo OOS.
Ahora el resultado es fantástico.
¿Has validado la estrategia Out-of-Sample?
No.
Has utilizado el OOS para mejorar la estrategia.
Ese periodo acaba de convertirse, al menos parcialmente, en información de desarrollo.
Da igual que el proceso haya sido manual.
Da igual que solo hayas cambiado tres cosas.
Da igual que nunca hayas pulsado un botón que diga “Optimize”.
Si una observación de los resultados hizo que cambiaras el sistema, esa información influyó en el desarrollo.
Puedes utilizar lo aprendido. De hecho, deberías.
Pero necesitas ser intelectualmente honesto sobre qué datos siguen siendo realmente nuevos.
Cuando quieras repetir este ciclo de forma estructurada, entrará en juego el Walk-Forward Analysis.
No voy a desarrollar esa técnica aquí porque tiene su propia lección. Lo importante ahora es entender por qué existe.
¿Cuánto debería reservar para In-Sample y Out-of-Sample?
Es frecuente encontrar divisiones como:
- 70% IS / 30% OOS;
- 80% IS / 20% OOS.
Pueden servir como referencias.
No las convertiría en leyes.
La pregunta importante no es:
“¿Utilicé exactamente un 30% para OOS?”
La pregunta importante es:
“¿Tengo suficiente información en ambas muestras para que lo que estoy observando resulte mínimamente representativo?”
Veamos por qué.
Supongamos que tienes cinco años de histórico.
Sistema A
Genera aproximadamente 400 operaciones al año.
Un 20% del histórico podría darte cientos de operaciones OOS.
Sistema B
Genera ocho operaciones al año.
El mismo 20% podría dejarte con ocho operaciones Out-of-Sample.
El porcentaje es idéntico.
La cantidad de evidencia no tiene nada que ver.
Por eso esta lección viene justo después de cuántas operaciones necesita un backtest.
Ya aprendiste que el tamaño de muestra importa.
Ahora añadimos una segunda capa:
no solo necesitas suficientes observaciones; también necesitas decidir cuáles utilizas para desarrollar y cuáles conservas para evaluar.
Ejemplo completo de In-Sample vs Out-of-Sample
Supongamos que quieres evaluar una estrategia hipotética sobre EUR/USD y tienes diez años de información histórica.
Antes de comenzar decides:
Primeros siete años → In-Sample
Últimos tres años → Out-of-Sample
Durante el periodo IS desarrollas el sistema.
Después de terminar, tienes 560 operaciones históricas.
Congelas las reglas.
Ahora ejecutas exactamente ese mismo sistema sobre los tres años OOS.
Obtienes otras 210 operaciones.
¿Qué deberías esperar?
No necesariamente que los resultados sean iguales.
Veamos varios escenarios.
Escenario 1: el OOS es algo peor, pero mantiene coherencia
Imagina estos números puramente ilustrativos:
| Métrica | In-Sample | Out-of-Sample |
|---|---|---|
| Operaciones | 560 | 210 |
| Win rate | 47% | 44% |
| Ganancia media | 1.6 R | 1.5 R |
| Pérdida media | -1 R | -1 R |
| Expectativa | Positiva | Positiva |
El OOS es peor.
¿Eso significa que el sistema fracasó?
No necesariamente.
De hecho, existe una razón bastante intuitiva por la que el IS puede verse mejor: ahí tomaste las decisiones de desarrollo.
El dato interesante es que el sistema continúa mostrando un comportamiento parecido fuera de esa muestra.
No demuestra que vaya a hacerlo en el futuro.
Pero sí aporta más información que decir:
“Funcionó muy bien en los datos con los que lo construí.”
Escenario 2: el OOS se derrumba
Ahora imagina que durante el periodo Out-of-Sample:
- desaparece la expectativa positiva;
- aumenta mucho el drawdown;
- cambia radicalmente la frecuencia;
- el payoff se deteriora;
- los costes consumen prácticamente toda la ventaja.
Ahí yo tendría cuidado.
Puede haber muchas explicaciones:
- sobreajuste;
- dependencia de un régimen concreto;
- poca muestra;
- costes mal modelados;
- cambios estructurales;
- problemas de datos;
- simple variabilidad estadística.
El OOS por sí mismo no te dice cuál es la causa.
Pero sí te dice algo muy importante:
lo que observaste durante el desarrollo no se trasladó bien a la muestra reservada.
Eso ya merece investigar.
Escenario 3: el OOS es espectacular
También podría ocurrir lo contrario.
El sistema obtiene resultados mucho mejores fuera de muestra.
¿Eso demuestra que es extraordinario?
Tampoco.
Tal vez el nuevo periodo fue especialmente favorable para ese tipo de estrategia.
Quizá hubo tendencias mucho más limpias.
Tal vez la muestra sigue siendo pequeña.
O simplemente estás observando una combinación afortunada de resultados.
Un OOS excepcional también necesita contexto.
La finalidad de una validación no es conseguir un número bonito.
Es obtener información menos contaminada por tus propias decisiones de desarrollo.
El Out-of-Sample no tiene que ser una copia del In-Sample
Esta es otra fuente frecuente de confusión.
No necesitas que IS y OOS tengan exactamente:
- el mismo win rate;
- el mismo retorno;
- el mismo profit factor;
- el mismo drawdown;
- la misma frecuencia;
- la misma duración media;
- la misma distribución de operaciones.
Los mercados cambian.
Puede cambiar la volatilidad.
Puede cambiar la frecuencia de tendencias.
Puede cambiar la liquidez.
Puede cambiar la relación entre variables.
Puede cambiar el impacto de costes sobre determinadas estrategias.
Por eso la pregunta no debería ser:
“¿Las métricas son idénticas?”
La pregunta debería acercarse más a:
“¿El comportamiento sigue siendo compatible con la hipótesis que estoy evaluando o se ha producido una degradación que pone en duda el sistema?”
Un deterioro moderado no invalida automáticamente una estrategia.
Del mismo modo, una coincidencia casi perfecta tampoco demuestra robustez.
Las métricas concretas y su interpretación tendrán su propio espacio más adelante en el curso.
Aquí nos interesa el diseño de la prueba.
Qué hacer si el sistema falla Out-of-Sample
Para mí, un OOS malo puede ser extraordinariamente útil.
Acabas de encontrar un problema antes de descubrirlo con dinero real.
Lo que no haría sería convertir la prueba en este proceso:
- falla;
- cambio parámetros;
- falla;
- añado filtro;
- falla;
- elimino las operaciones malas;
- por fin gana;
- declaro que pasó el OOS.
Eso no es validación.
Es optimización sobre una muestra a la que seguimos llamando Out-of-Sample.
Cuando el resultado sale mal, primero intentaría entender qué ocurrió.
¿La hipótesis económica o de mercado sigue teniendo sentido?
¿Hay demasiados parámetros?
¿Los resultados del IS estaban sostenidos por muy pocas operaciones?
¿Existe una condición de mercado de la que depende excesivamente el sistema?
¿Los costes reales podrían comerse la ventaja?
¿El periodo OOS contiene suficientes operaciones?
¿Hay algún error de datos?
¿Seleccionaste esta estrategia después de comparar muchas alternativas?
No siempre vas a obtener una respuesta definitiva.
Y eso está bien.
El trading sistemático no consiste en fabricar certeza. Consiste en ir sometiendo una hipótesis a pruebas cada vez más difíciles.
El problema de probar demasiadas estrategias
Hay una variante más sutil del mismo problema.
Supongamos que desarrollas 100 sistemas diferentes.
Mantienes un periodo OOS aparentemente limpio.
Después ejecutas los 100 sistemas sobre ese OOS y eliges el que consiguió mejores resultados.
¿Sigue siendo ese OOS una prueba completamente independiente para el sistema elegido?
No realmente.
Lo utilizaste para seleccionar al ganador.
Puede que no hayas modificado sus parámetros, pero utilizaste esa información para tomar una decisión.
Esta es una idea crucial porque el sobreajuste no aparece únicamente cuando mueves una media de 50 a 51.
También puede aparecer a nivel de selección.
¿Cuántas variantes probaste?
¿Cuántos filtros descartaste?
¿Cuántos mercados comparaste?
¿Cuántas versiones llegaron al OOS?
Cuantas más decisiones dependan de una misma muestra, menos puedes tratarla como información completamente nueva.
Por eso la separación IS/OOS es muy útil, pero no elimina mágicamente el overfitting.
Errores frecuentes al trabajar con In-Sample y Out-of-Sample
Hay unos cuantos que conviene reconocer rápido.
Mirar el OOS constantemente
Cada consulta puede condicionar la siguiente decisión.
Si ves que el sistema pierde muchísimo en determinada circunstancia y posteriormente añades una regla para evitarla, has utilizado esa información.
Dejar una muestra OOS demasiado pequeña
Diez operaciones siguen siendo diez operaciones aunque las llames “Out-of-Sample”.
La etiqueta no aumenta el contenido estadístico de la muestra.
Elegir retrospectivamente el mejor corte
Supongamos que pruebas:
- 60/40;
- 70/30;
- 75/25;
- 80/20.
Y finalmente publicas únicamente el corte que produce el resultado OOS más atractivo.
Acabas de utilizar también la separación como parámetro de selección.
Cambiar los costes entre muestras
Si una parte del backtest incluye unas fricciones y la otra se calcula bajo supuestos más favorables, la comparación pierde sentido.
El sistema tiene que probarse bajo supuestos coherentes.
Pensar que OOS corrige datos defectuosos
No lo hace.
Puedes tener una separación impecable y continuar utilizando una base que contiene un sesgo importante.
Por ejemplo, si analizas acciones y tu universo histórico solo contiene las empresas que sobrevivieron hasta hoy, estás introduciendo otro problema distinto.
Eso tiene su propia lección: Survivorship Bias en trading.
In-Sample/Out-of-Sample tampoco elimina todos los sesgos
Esta distinción es fundamental.
IS/OOS responde principalmente a una pregunta:
¿qué ocurre cuando aplico las reglas fuera de los datos que utilicé para desarrollarlas?
No responde automáticamente a todas las demás.
Todavía puedes tener:
- datos históricos deficientes;
- sesgo de supervivencia;
- información futura filtrándose en la simulación;
- costes irreales;
- errores de ejecución;
- reglas ambiguas;
- sobreoptimización;
- selección retrospectiva.
Una buena metodología de backtesting se construye por capas.
No existe una sola casilla que marques y convierta automáticamente un backtest en fiable.
Si después quieres practicar la ejecución de un sistema en una plataforma antes de arriesgar capital, puedes revisar Pepperstone y consultar las condiciones o promoción disponibles mediante nuestro enlace. Una plataforma puede ayudarte con la ejecución y las pruebas; no sustituye la calidad del diseño estadístico del sistema.
Out-of-Sample y forward testing no son lo mismo
Ambos conceptos intentan reducir un problema parecido: evaluar el sistema con información que no haya condicionado directamente su construcción.
Pero no son iguales.
| Out-of-Sample | Forward testing |
|---|---|
| Utiliza datos históricos reservados | Utiliza datos que van apareciendo posteriormente |
| Puedes evaluarlo en cuanto terminas el sistema | Necesitas que transcurra tiempo |
| Sigue formando parte del backtesting histórico | Prueba las reglas hacia adelante |
| La información ya existía, pero la mantuviste apartada | La información todavía no existía al congelar el sistema |
| Estudia generalización sobre histórico reservado | Añade otra capa de validación con datos posteriores |
La diferencia fundamental está en el tiempo.
En OOS puedes tener hoy toda la base de datos y simplemente esconder una parte durante el desarrollo.
En un forward test genuino, esas velas futuras todavía no existen cuando defines el sistema.
Por eso no son sustitutos.
Son capas diferentes de evidencia.
Llegaremos a esa fase en la lección específica sobre qué es el Forward Testing.
Entonces, ¿un buen Out-of-Sample demuestra que el sistema es robusto?
No.
Y creo que ésta es una de las ideas más importantes que puedes llevarte.
Un resultado OOS positivo significa que el sistema superó una prueba que un simple resultado In-Sample no había superado.
Eso es valioso.
Pero robustez implica hacer preguntas adicionales.
Por ejemplo:
- ¿qué ocurre al cambiar ligeramente los parámetros?;
- ¿depende demasiado de unas pocas operaciones?;
- ¿cómo responde en diferentes condiciones?;
- ¿qué pasa cuando empeoramos supuestos de ejecución?;
- ¿cómo cambia su distribución de resultados?;
- ¿qué tan sensible es a las decisiones de diseño?
Esas preguntas llegarán en el módulo dedicado a robustez.
No necesitamos adelantar todas sus respuestas aquí.
Por ahora:
OOS positivo ≠ sistema demostrado.
Significa:
OOS positivo = una pieza adicional de evidencia favorable.
Y esa forma de pensar es mucho más sana.
Una forma sencilla de visualizar todo el proceso
Yo lo ordenaría mentalmente así.
Datos históricos
Primero consigues y preparas información suficientemente buena para probar la hipótesis.
↓
In-Sample
Desarrollas.
Pruebas ideas, defines reglas y tomas decisiones.
↓
Sistema congelado
Dejas de cambiar las reglas.
↓
Out-of-Sample
Ejecutas esas mismas reglas sobre el periodo reservado.
↓
Interpretación
Estudias qué cambió y si el comportamiento sigue siendo razonablemente coherente.
↓
Pruebas posteriores
Si la estrategia sigue mereciendo investigación, puedes avanzar hacia sensibilidad, optimización, Walk-Forward, Monte Carlo, stress testing y forward testing.
Cada etapa responde una pregunta diferente.
Y esa secuencia importa.
Si aplicas herramientas sofisticadas a un sistema que todavía está mal definido, solo consigues analizar con mucha precisión algo que no estaba preparado para ser analizado.
¿Qué hago después de superar un OOS?
No correría directamente a operar con dinero real.
Primero entendería qué acaba de demostrar realmente la prueba.
Has aprendido que una estrategia definida previamente consiguió mantener cierto comportamiento sobre información histórica que no utilizaste para construirla.
Eso es bastante mejor que tener solo un backtest optimizado sobre toda la muestra.
Pero todavía no sabes qué hará el mercado futuro.
Tampoco sabes necesariamente cómo se comportará la ejecución real.
La evidencia se construye poco a poco.
Más adelante podrás combinarla con otras pruebas y, cuando corresponda, observar el sistema hacia adelante.
Para esa fase práctica, puedes consultar Pepperstone y la promoción disponible al abrir tu cuenta mediante nuestro enlace. Revisa siempre las condiciones actuales antes de operar y recuerda que practicar una metodología no elimina el riesgo cuando posteriormente utilizas capital real.
La idea que quiero que te lleves
Separar In-Sample y Out-of-Sample no sirve para hacer que un backtest parezca más profesional.
Sirve para plantearte una pregunta bastante incómoda:
¿estoy viendo una característica que parece pertenecer al sistema o simplemente algo que conseguí adaptar al histórico que ya conocía?
El In-Sample es tu laboratorio.
Ahí puedes investigar, ajustar y equivocarte.
El Out-of-Sample es una primera oportunidad de sacar el sistema de ese laboratorio y comprobar qué ocurre cuando las reglas ya no pueden adaptarse a las respuestas.
Pero no es un certificado.
No elimina por sí solo el sobreajuste.
No arregla datos malos.
No corrige otros sesgos.
No garantiza resultados futuros.
Y precisamente por eso es útil: te obliga a pedirle más evidencia a una estrategia antes de creer su backtest.
Dentro del curso, ya has aprendido dos piezas que encajan directamente.
Primero vimos cuántas operaciones necesita un backtest: no puedes extraer conclusiones sólidas de una muestra que apenas contiene información.
Ahora añadimos otra regla: no conviene utilizar exactamente la misma información para desarrollar el sistema y después presumir de que esa misma información lo valida.
El siguiente problema es distinto y especialmente peligroso.
¿Qué ocurre si tu simulación utiliza, aunque sea accidentalmente, información que el trader todavía no podía conocer en el momento de tomar la decisión?
Eso es el Look-Ahead Bias, y es el siguiente paso del módulo.