Qué es el overfitting en trading
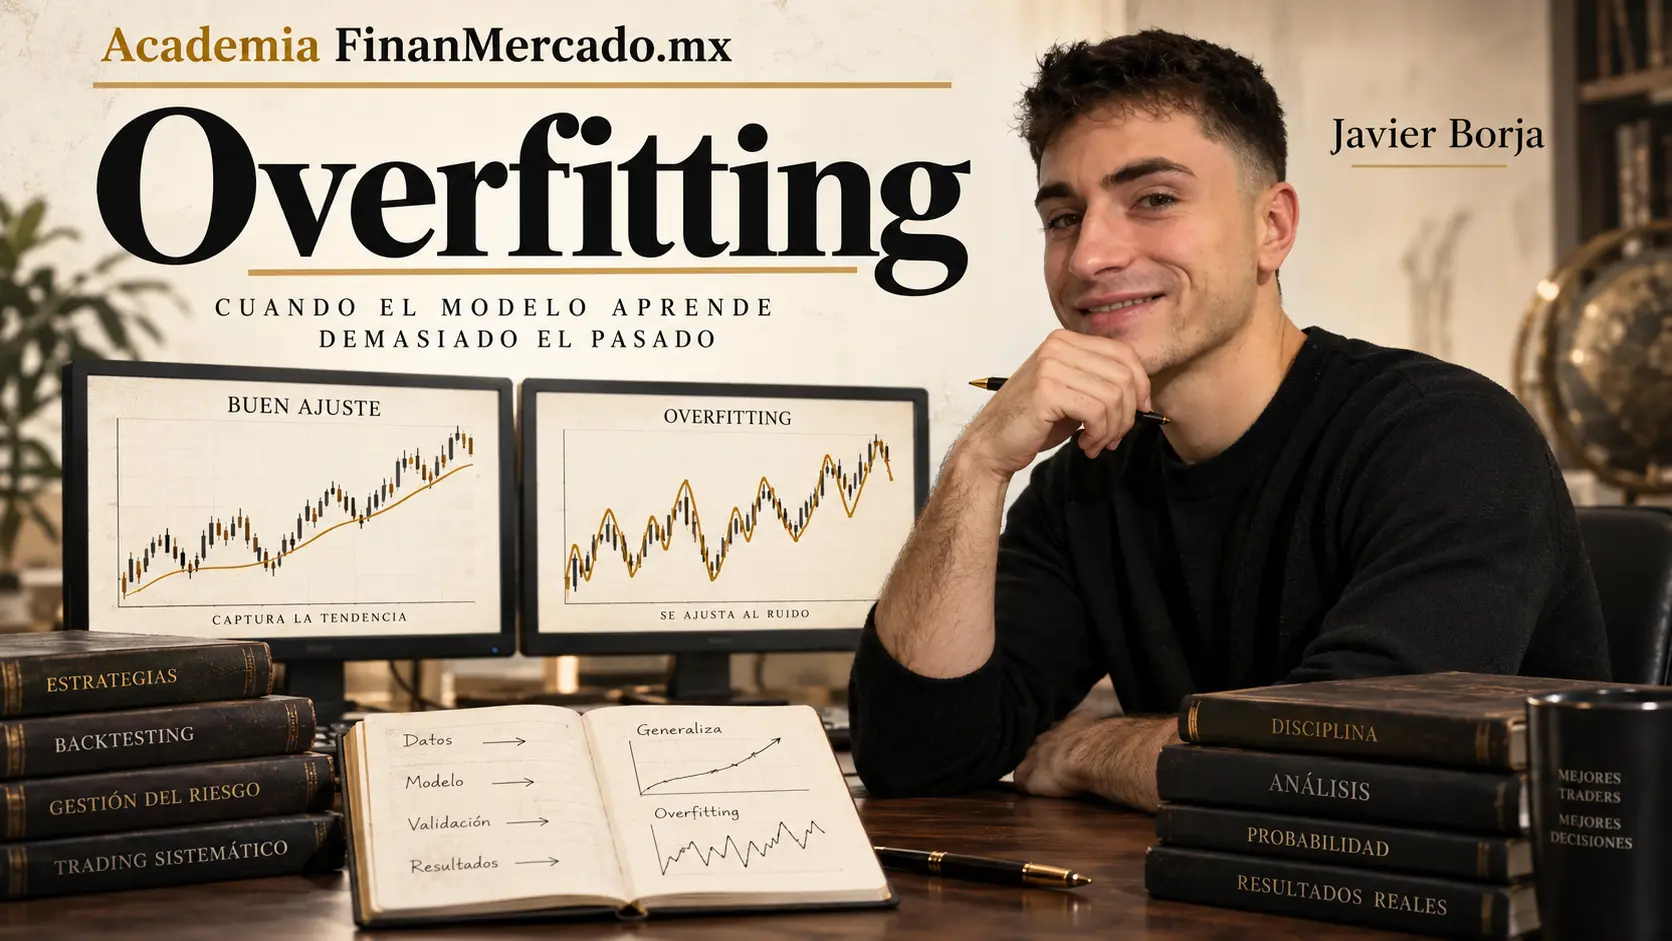
El overfitting ocurre cuando las reglas, filtros o parámetros de un sistema han sido seleccionados de una forma tan específica para una muestra histórica que el resultado deja de representar únicamente la posible ventaja de la estrategia y empieza a incorporar el ruido particular de esa muestra.
Dicho de otra forma: el sistema aprende demasiado bien el examen que ya conoce.
Supongamos que tienes una estrategia tendencial basada en dos medias móviles. Pruebas distintas longitudes y descubres que 17 y 83 periodos producen una curva excelente.
Hasta aquí no sabemos si encontraste algo útil.
Ahora cambias 17 por 16 y el resultado se deteriora muchísimo. Pruebas 18 y también. Con 80 o 85 para la media larga ocurre lo mismo. Solo esa combinación concreta funciona de forma excepcional.
Yo ahí no celebraría haber encontrado el parámetro perfecto. Me preguntaría por qué existe un pico tan estrecho.
Una estrategia con cierta lógica subyacente suele tolerar, al menos hasta cierto punto, pequeñas modificaciones que no alteran su idea central. Cuando mover un parámetro ligeramente destruye el resultado, existe una posibilidad seria de que hayas ajustado la estrategia a circunstancias históricas muy concretas.
Los trabajos de Bailey, Borwein, López de Prado y Zhu sobre backtest overfitting parten precisamente de este problema: seleccionar entre muchas estrategias o configuraciones utilizando los mismos datos puede producir un ganador extraordinario dentro de la muestra que después se comporte mucho peor fuera de ella.
Y esto encaja con una regla que utilizamos en toda esta parte del curso: una curva bonita no equivale a robustez y un backtest bonito no demuestra por sí solo que una estrategia seguirá funcionando.
Si todavía necesitas reforzar la base, conviene tener claro primero qué es el backtesting y qué puede demostrar realmente.
El verdadero problema no es optimizar: es elegir después de mirar
Aquí hay un matiz que me parece fundamental.
Se suele explicar el overfitting como si simplemente significara “usar demasiados parámetros”. Es una explicación incompleta.
Puedes sobreajustar un sistema con pocos parámetros si has tomado suficientes decisiones después de observar los resultados.
Imagina este ejemplo hipotético. Quieres construir un sistema con:
- una media rápida entre 5 y 30 periodos;
- una media lenta entre 40 y 200, avanzando de 5 en 5;
- un stop entre 0.5 y 3 ATR, avanzando de 0.1 en 0.1.
Solo esas tres decisiones generan:
26 × 33 × 26 = 22,308 combinaciones.
Ahora ejecutas todas y eliges la que produjo el mejor resultado histórico.
El problema no es que la combinación ganadora necesariamente sea mala. El problema es que le diste 22,308 oportunidades a la suerte para producir algo que pareciera extraordinario.
Y los grados de libertad reales pueden ser muchos más.
También estás eligiendo si usar EUR/USD o GBP/USD, gráficos de 15 minutos o una hora, sesión europea o estadounidense, qué años incluir, qué indicador añadir, qué operaciones excluir, qué condición utilizar como filtro y qué métrica maximizar.
Cada elección realizada después de mirar el histórico abre otra oportunidad para adaptar la estrategia al pasado.
Halbert White describió este problema en estadística financiera como data snooping: reutilizar los mismos datos para selección e inferencia aumenta la posibilidad de terminar atribuyendo a un método resultados que podrían haber aparecido simplemente por azar.
Por eso el número de reglas visibles de un sistema no cuenta toda la historia.
A mí me interesa también saber cuántas ideas murieron antes de que me enseñaras la ganadora.
Overfitting y sobreoptimización no son exactamente lo mismo
Están estrechamente relacionados, pero conviene separarlos.
Optimizar significa explorar cómo se comporta una estrategia cuando modificas determinados parámetros.
Eso puede ser completamente razonable.
Sobreoptimizar significa empujar ese proceso hasta seleccionar una configuración principalmente porque explica extraordinariamente bien el pasado.
El overfitting es el problema resultante: has terminado con un modelo cuya aparente calidad depende demasiado de las particularidades de los datos utilizados para construirlo.
Por eso no quiero que salgas de esta lección pensando que optimizar es malo.
De hecho, más adelante veremos cómo optimizar los parámetros de una estrategia de una forma mucho más útil. La diferencia está en qué pregunta haces.
Una mala pregunta sería:
¿Qué combinación produjo el máximo beneficio histórico?
Una pregunta bastante mejor es:
¿En qué rango de parámetros el comportamiento del sistema permanece razonablemente estable?
No estás buscando el número mágico. Estás intentando comprender la estructura del sistema.
El documento de redacción de la Academia marca precisamente esta diferencia: optimizar para estudiar sensibilidad no es lo mismo que optimizar para encontrar el parámetro que mejor explica el pasado.
La mejor configuración puede ser simplemente la más afortunada
Imagina que pruebas 1,000 estrategias que, en realidad, no tienen ninguna ventaja.
No todas producirán el mismo resultado histórico.
Algunas perderán mucho. Otras quedarán cerca de cero. Y algunas, simplemente por variabilidad aleatoria, tendrán resultados bastante buenos.
Si después enseñas únicamente la mejor, parecerá que descubriste una estrategia.
Pero hiciste otra cosa: seleccionaste el extremo favorable de una distribución de resultados.
Este problema se vuelve todavía más serio cuando la investigación permite probar enormes cantidades de combinaciones. Bailey y López de Prado señalan que no controlar el número de pruebas realizadas puede inflar las expectativas sobre el rendimiento observado y desarrollaron el Deflated Sharpe Ratio precisamente para abordar, entre otros factores, el sesgo de selección asociado a múltiples pruebas.
No necesitas utilizar esa métrica para entender esta lección.
Quédate con la lógica.
Si alguien prueba una estrategia y obtiene un buen resultado, tienes una evidencia.
Si prueba diez mil estrategias y solo te enseña la mejor, el mismo buen resultado significa algo distinto.
El proceso que generó el resultado importa.
Cómo reconocer un posible sistema sobreajustado
No existe una señal aislada que permita mirar un backtest y sentenciar: “esto tiene overfitting”.
Lo razonable es buscar varias señales que, juntas, reduzcan tu confianza en que el resultado sea generalizable.
| Señal | Por qué me hace desconfiar |
|---|---|
| Resultado extraordinario dentro de muestra y fuerte deterioro fuera de muestra | Puede indicar que las reglas aprendieron peculiaridades del periodo utilizado para construirlas |
| Una configuración concreta funciona mucho mejor que parámetros casi idénticos | Sugiere una solución frágil en lugar de una zona estable |
| El sistema acumula filtros muy específicos | Cada filtro añade posibilidades de explicar retrospectivamente operaciones pasadas |
| Se probaron cientos o miles de variantes y solo se presenta la mejor | Aumenta el problema de selección y múltiples pruebas |
| Una parte muy grande del resultado depende de unas pocas operaciones | La aparente ventaja puede descansar en eventos difíciles de repetir |
| Cada nuevo periodo malo provoca añadir otra excepción | El sistema empieza a perseguir el histórico en lugar de someterse a una prueba |
| El supuesto out-of-sample se consulta una y otra vez durante el desarrollo | Ese periodo deja de funcionar realmente como datos no vistos |
Ninguna fila demuestra por sí sola que exista overfitting.
Por ejemplo, una estrategia perfectamente válida puede funcionar mejor en unos regímenes de mercado que en otros. Tampoco tiene por qué producir exactamente los mismos resultados con parámetros cercanos.
Lo que estamos buscando es fragilidad excesiva respecto de decisiones que, en teoría, no deberían transformar completamente la ventaja.
Por eso más adelante dedicaremos una lección completa al análisis de sensibilidad. Ahí sí entraremos en cómo estudiar de forma sistemática qué ocurre alrededor del parámetro que elegiste.
El tamaño de muestra importa más de lo que parece
Cuantos más grados de libertad introduces, más evidencia necesitas.
No existe una cifra universal de operaciones que elimine el riesgo de overfitting. Un sistema con 500 operaciones tampoco queda automáticamente validado.
Pero hay una relación que sí debes entender.
Si tienes muy poca información histórica y realizas muchísimas elecciones sobre ella, es extremadamente fácil terminar explicando accidentes de esa muestra.
Supongamos que un sistema produjo 38 operaciones.
Ahora añades seis filtros y ajustas tres parámetros basándote en esas mismas 38 operaciones.
En el fondo, estás intentando aprender una cantidad enorme de información a partir de muy pocas observaciones.
Ese problema merece estudiarse por separado, por eso ya vimos cuántas operaciones necesita realmente un backtest.
Aquí solo quiero que conectes las dos ideas:
muestra limitada + muchas decisiones adaptativas = terreno fértil para el overfitting.
El out-of-sample ayuda, pero puedes contaminarlo sin darte cuenta
Separar datos de desarrollo y datos no utilizados para construir la estrategia es una de las herramientas básicas para combatir el sobreajuste.
Ya trabajamos esa lógica en In-Sample vs Out-of-Sample.
Pero existe una trampa muy común.
Supongamos que construyes tu sistema con datos de 2016 a 2022 y reservas 2023-2024 como out-of-sample.
Lo pruebas.
Sale mal.
Entonces vuelves al sistema, cambias el stop, añades un filtro de volatilidad y vuelves a probarlo sobre 2023-2024.
Mejora.
Cambias otra cosa. Lo vuelves a mirar.
Después de varias vueltas dices:
“Ahora sí funciona también fuera de muestra”.
No exactamente.
Has empezado a entrenar indirectamente sobre tu out-of-sample.
Cada vez que observas su resultado y esa información afecta a la siguiente versión de la estrategia, ese periodo participa en el proceso de selección.
Ya no es una prueba completamente independiente.
Ésta es una de las razones por las que el problema del sobreajuste financiero es más complejo que simplemente separar una vez los datos en dos bloques. El trabajo sobre la Probability of Backtest Overfitting advierte precisamente que procedimientos convencionales de hold-out pueden resultar insuficientes en determinados procesos de selección de estrategias.
Más adelante veremos una respuesta más estructurada a este problema mediante el Walk-Forward Analysis. Aquí no hace falta adelantarnos a su metodología. Lo importante es comprender por qué existe.
Cómo reducir el overfitting al crear un sistema
Yo intentaría que el proceso de investigación pusiera obstáculos al sobreajuste desde el principio, en lugar de intentar detectarlo únicamente después de tener una curva espectacular.
- Empieza por una hipótesis, no por una curva. Define qué comportamiento del mercado intentas explotar y por qué podría existir antes de empezar a ajustar parámetros. Una explicación económica o conductual razonable no demuestra que exista un edge, pero reduce la libertad de inventar reglas únicamente porque funcionaron en el histórico.
- Decide las reglas importantes antes de mirar su resultado final. Si cada pérdida histórica genera una nueva excepción, las reglas dejan de ser una prueba y empiezan a convertirse en una descripción del pasado.
- Protege datos que el proceso de desarrollo no haya visto. El out-of-sample pierde valor cada vez que utilizas su resultado para tomar la siguiente decisión.
- Registra cuántas variantes probaste. No es lo mismo encontrar una estrategia después de cinco pruebas razonadas que escogerla como ganadora entre 50,000 configuraciones. El historial de investigación también es información.
- Prefiere estabilidad a precisión milimétrica. Si parámetros 18, 19, 20, 21 y 22 producen comportamientos parecidos, me da más confianza que un enorme pico exactamente en 19 y resultados mediocres a ambos lados. No demuestra robustez, pero es una señal bastante más sana.
- Exige una muestra adecuada para la complejidad que estás introduciendo. Cuantas más decisiones libres tenga el sistema, mayor debe ser la evidencia que pretenda sostenerlas.
- Trata la validación como un proceso distinto de la optimización. Sensibilidad, walk-forward y otras pruebas existen para intentar romper el sistema, no para seguir embelleciendo su resultado. Todo esto acabará convergiendo más adelante en la lección sobre cómo comprobar la robustez de un sistema de trading.
Fíjate en algo: ninguna de estas reglas pretende conseguir el backtest más bonito.
Pretenden hacer más difícil engañarte a ti mismo.
Una demo tampoco demuestra que hayas eliminado el overfitting
Una vez que congelas una versión del sistema, tiene sentido empezar a observar cómo se comporta fuera del entorno exacto en el que fue construido.
Pero hay que separar dos preguntas.
Una cuenta demo puede ayudarte a comprobar que las reglas se pueden ejecutar, que la plataforma hace lo que esperabas o que tu lógica operativa funciona correctamente. No demuestra por sí misma que exista una ventaja estadística.
Pepperstone ofrece cuentas demo y acceso a plataformas como MetaTrader 5, cTrader y TradingView. Si quieres utilizar un entorno de práctica para ejecutar una versión ya congelada de tu sistema sin poner capital en riesgo, puedes revisar Pepperstone y consultar la promoción disponible mediante nuestro enlace.
Antes de abrir una cuenta, yo revisaría también qué entidad legal te corresponde, las condiciones aplicables a tu residencia y los riesgos del producto que vayas a operar. Pepperstone indica que su documentación y marco regulatorio dependen de la entidad con la que se registre cada cliente.
Y si hablamos de CFDs, el apalancamiento sigue siendo riesgo aunque el sistema haya pasado un backtest excelente.
Overfitting no es la única razón por la que un sistema falla fuera del backtest
Esta distinción evita otro error bastante habitual.
Un sistema puede deteriorarse después del periodo histórico y no haber estado necesariamente sobreajustado.
Quizá cambió el régimen de volatilidad. Quizá desapareció temporalmente una ineficiencia. Tal vez las comisiones, el spread o el slippage reales eran peores de lo supuesto. Puede existir un error de datos o una diferencia entre la lógica teórica y la ejecución.
También puede ocurrir lo contrario: una estrategia sobreajustada puede funcionar bien durante un tiempo fuera de muestra simplemente por suerte.
Por eso yo evitaría este razonamiento:
“Funcionó en real, entonces no había overfitting.”
No se sigue necesariamente.
La pregunta correcta sigue siendo la calidad de la evidencia.
¿Qué proceso utilizaste para construir el sistema y cuánto de ese resultado podría depender de haber elegido retrospectivamente lo que mejor encajaba?
Overfitting, look-ahead bias y survivorship bias no son el mismo problema
Los tres pueden producir un backtest mucho mejor de lo que debería, pero por razones distintas.
Con look-ahead bias, el test utiliza información que el trader todavía no podía conocer en el momento de tomar la decisión.
Con survivorship bias, la muestra omite entidades que desaparecieron o quedaron fuera del universo analizado, por lo que estás reconstruyendo el pasado con una población sesgada.
Con overfitting, en cambio, puedes tener datos perfectamente válidos y disponibles en su momento. El problema está en haber utilizado esos datos demasiadas veces para seleccionar reglas, mercados, parámetros o filtros.
Esta diferencia importa porque la solución tampoco es la misma.
Limpiar los datos no elimina el overfitting.
Añadir costes realistas tampoco.
Tener cero look-ahead bias tampoco.
Puedes construir un backtest técnicamente impecable y seguir habiendo exprimido tanto la muestra que el sistema termine describiendo su ruido.
No necesitas un algoritmo para hacer overfitting
Esto también ocurre en trading discrecional.
Imagina que revisas cien operaciones históricas y terminas diciendo:
“Mi setup funciona, excepto cuando la vela anterior es demasiado grande, salvo los martes por la mañana, y siempre que el RSI esté por debajo de 58, pero no si hay una resistencia muy cerca.”
Quizá todas esas condiciones tengan sentido.
Pero si fueron apareciendo una por una después de mirar qué habría evitado cada pérdida, acabas de hacer ajuste de curva manual.
El ordenador simplemente puede hacerlo más rápido.
Una persona puede sobreajustar exactamente igual si modifica sus reglas después de conocer el resultado y nunca registra las versiones descartadas.
Por eso las reglas deben ser suficientemente claras para poder someterse a prueba y, cuando añades una variable, debería existir una razón mejor que “mejora la curva”.
Yo lo resumiría así:
cada regla nueva tiene que ganarse el derecho a existir.
El sistema más simple tampoco es automáticamente mejor
Cuidado con irse al otro extremo.
Después de entender el overfitting es fácil pensar:
“Entonces utilizaré dos reglas y cero parámetros.”
No funciona así.
Una estrategia simple puede carecer completamente de ventaja.
La simplicidad es útil porque reduce grados de libertad, facilita comprender qué está haciendo el sistema y disminuye algunas oportunidades de ajustar ruido. Pero simplicidad no sustituye evidencia.
Una estrategia compleja puede ser válida si cada componente tiene una función justificable y supera una validación seria.
Una estrategia sencilla puede ser basura.
La pregunta no es cuántas reglas existen en términos absolutos.
Es cuánto soporte empírico tienes para las decisiones que estás tomando.
Una prueba que me gusta hacer: cambia algo que no debería importar demasiado
Imagina que tu sistema utiliza una media de 50 periodos.
Prueba 45. Prueba 55.
No porque quieras encontrar un parámetro todavía mejor, sino porque quieres hacer una pregunta diferente:
¿la lógica sobrevive a una pequeña perturbación?
Después cambia ligeramente la fecha inicial del backtest.
O elimina algunas operaciones al azar.
O utiliza un periodo de mercado distinto.
No esperes resultados idénticos. Eso sería absurdo.
Lo que estás observando es si la estrategia sigue pareciendo la misma estrategia o si cualquier pequeño movimiento hace que desaparezca por completo.
Ese cambio de mentalidad es importante.
Cuando estás desarrollando, quieres mejorar.
Cuando estás validando, quieres intentar romper.
Confundir ambos momentos es una de las formas más fáciles de terminar sobreajustando.
¿Cuándo debería empezar a preocuparme de verdad?
Yo haría preguntas bastante incómodas antes de confiar en un resultado muy bueno.
¿Cuántas versiones probaste antes de quedarte con ésta? ¿Los parámetros cercanos también funcionan razonablemente? ¿Existe una razón para cada filtro? ¿El out-of-sample permaneció realmente intacto? ¿Cuántas operaciones sostienen el resultado? ¿La estrategia funciona en distintas partes de la muestra o prácticamente todo ocurrió durante un periodo concreto? ¿Las reglas existían antes de ver las operaciones que pretenden explicar?
Y, sobre todo:
si te diera otro histórico razonablemente representativo que nunca hubieras visto, ¿esperarías que la lógica sobreviviera o necesitarías volver a ajustar todo?
Ésa es la pregunta que el overfitting nos obliga a hacer.